开云体育(中国)官方网站为止相等出色! 执行中-开云(中国区)Kaiyun·官方网站 登录入口
专题:DeepSeek为何能振荡寰球AI圈
开头:新智元
这些天,硅谷透顶处于中国公司带来的地面震余波中。
全好意思都在心焦:是否寰球东说念主工智能的中心一经改造到了中国?
就在这当口,寰球复现DeepSeek的一波怒潮也来了。
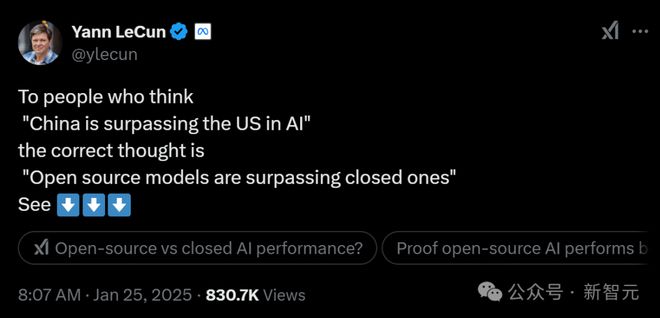
诚如LeCun所言:‘这一次,恰是开源对闭源的成效!’
万般这些不雅点和探讨,让东说念主不禁怀疑:数百亿好意思元支拨,对这个行业确切必要吗?甚而有东说念主说,中国量化基金的一群天才,将导致纳斯达克崩盘。
从此,大模子时期很可能会插足一个分水岭:超强性能的模子不再独属于算力巨头,而是属于每个东说念主。
30好意思金,就能看到‘啊哈’时刻
来自UC伯克利博士生潘家怡和另两位筹办东说念主员,在CountDown游戏中复现了DeepSeek R1-Zero。
他们默示,为止相等出色!
执行中,团队考证了通过强化学习RL,3B的基础话语模子也能够自我考证和搜索。
更令东说念主隆盛的是,资本不到30好意思金(约217元),就可以亲眼见证‘啊哈’时刻。
这个技俩叫作念TinyZero,汲取了R1-Zero算法——给定一个基础话语模子、领导和真确奖励信号,运行强化学习。
然后,团队将其运用在CountDown游戏中(这是一个玩家使用基础算术运算,将数字组合以达到方针数字的游戏)。
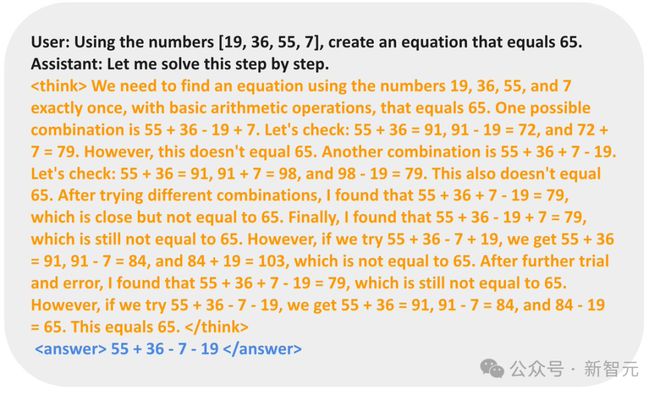
模子从当先的浅易输出脱手,徐徐进化出自我矫正和搜索的战略。
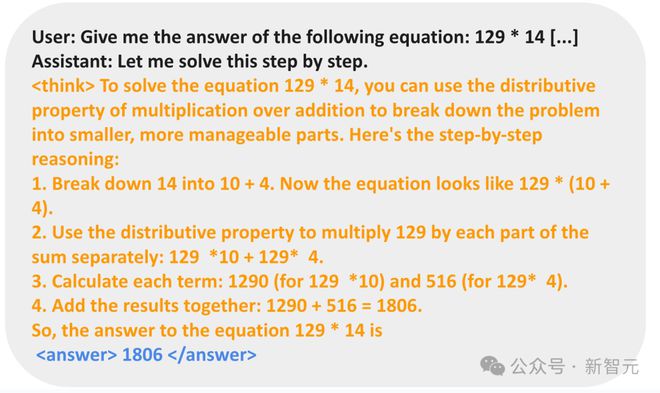
在以下示例中,模子提议了处置有缱绻,自我考证,并反复矫正,直到处置问题为止。
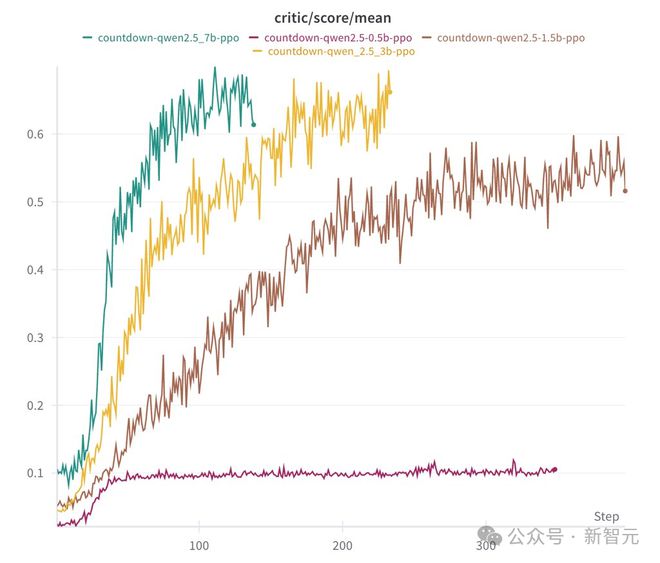
在消融执行中,筹办东说念主员运行了Qwen-2.5-Base(0.5B、1.5B、3B、7B四种参数畛域)。
为止发现,0.5B模子只是是估计一个处置有缱绻然后住手。而从1.5B脱手,模子学会了搜索、自我考证和修正其处置有缱绻,从而能够获取更高的分数。
他们合计,在这个流程,基础模子的是性能的关节。
他们还考证了,非常的指示微调(SFT)并非是必要的,这也印证了R1-Zero的联想决策。
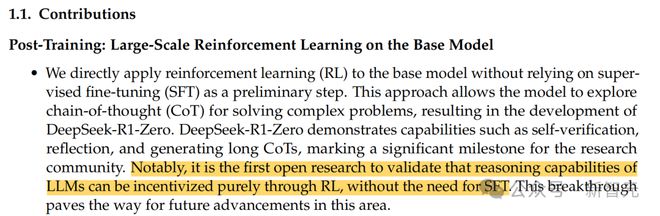
这是首个考证LLM推理能力的达成可以贞洁通过RL,无需监督微调的开源筹办
基础模子和指示模子两者区别:
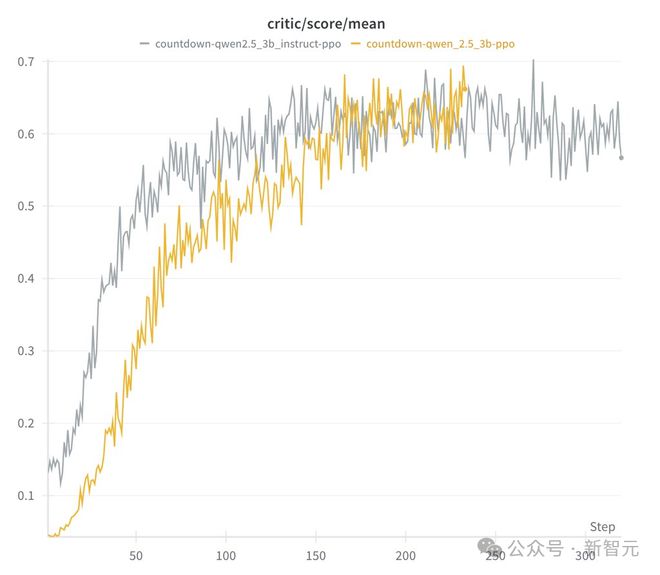
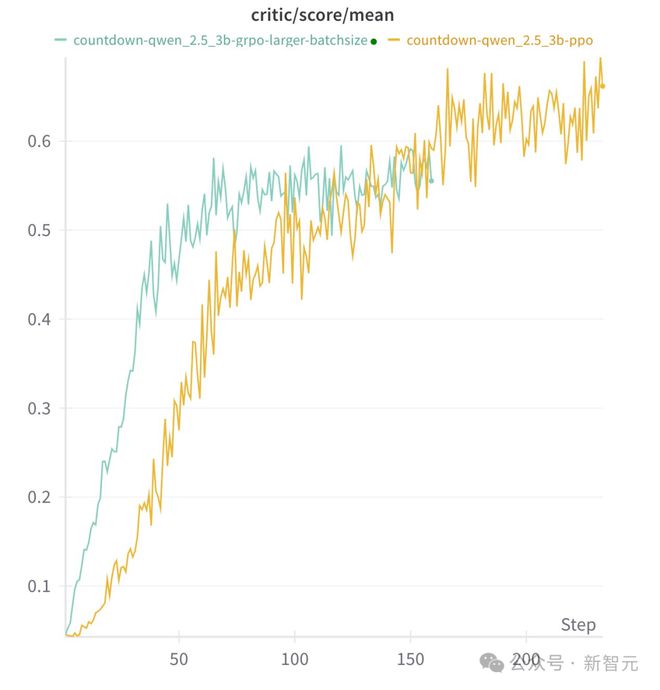
此外,他们还发现,具体的RL算法并不蹙迫。PPO、GRPO、PRIME这些算法中,长想维链(Long CoT)都能够涌现,且带来可以的性能阐扬。
而且,模子在推理行动中相等依赖于具体的任务:
苹果机器学习科学家Yizhe Zhang对此默示,太酷了,小到1.5B的模子,也能通过RL涌现出自我考证的能力。
7B模子复刻,为止令东说念主讶异
港科大助理教师何俊贤的团队(共归并作黄裕振、Weihao Zeng),只用了8K个样本,就在7B模子上复刻出了DeepSeek-R1-Zero和DeepSeek-R1的考验。
为止令东说念主惊喜——模子在复杂的数学推理上取得了十分强盛为止。

技俩地址:https://github.com/hkust-nlp/simpleRL-reason
他们以Qwen2.5-Math-7B(基础模子)为最先,径直对其进行强化学习。
系数这个词流程中,莫得进行监督微调(SFT),也莫得使用奖励模子。
最终,模子在AIME基准上达成了33.3%的准确率,在AMC上为62.5%,在MATH上为77.2%。
这一阐扬不仅特殊了Qwen2.5-Math-7B-Instruct,何况还可以和使用向上50倍数据量和更复杂组件的PRIME和rStar-MATH相比好意思!
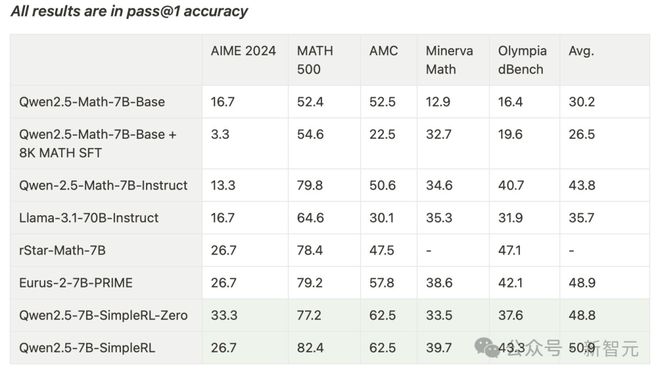
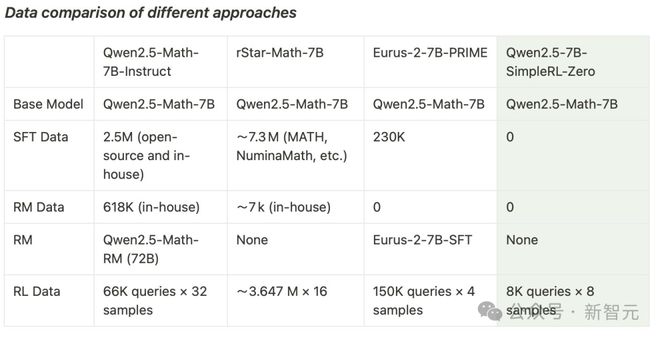
其中,Qwen2.5-7B-SimpleRL-Zero是在Qwen2.5-Math-7B基础模子上仅使用纯PPO行动考验的,仅汲取了MATH数据连合的8K样本。
Qwen2.5-7B-SimpleRL则最先通过Long CoT监督微调(SFT)当作冷启动,然后再进行强化学习。
在这两种行动中,团队都只使用了疏通的8K MATH样本,仅此良友。
粗略在第44步的时分,‘啊哈时刻’出现了!模子的反馈中,出现了自我反想。
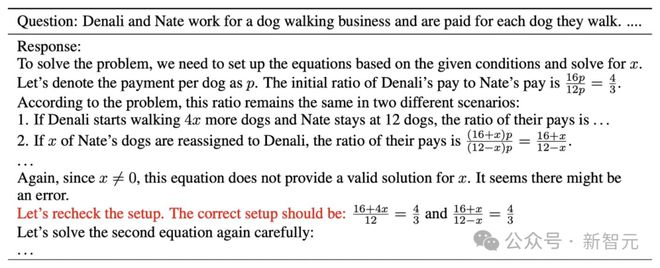
何况,在这个流程中,模子还暴露了更长的CoT推理能力和自我反想能力。
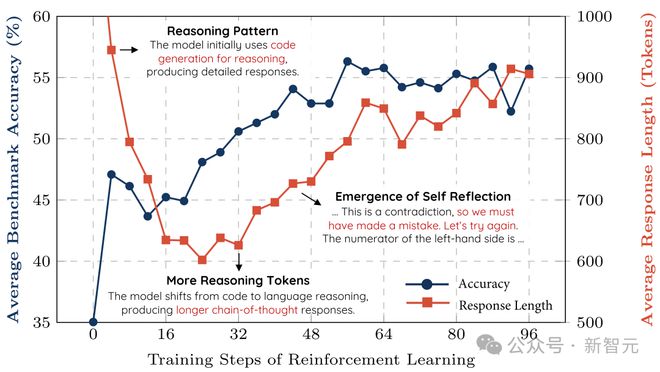
在博客中,筹办者详备分解了执行建树,以及在这个强化学习考验流程中所不雅察到的风景,举例长链式想考(CoT)和自我反想机制的自觉酿成。
与DeepSeek R1雷同,筹办者的强化学习有缱绻极其浅易,莫得使用奖励模子或MCTS(蒙特卡洛树搜索)类技能。
他们使用的是PPO算法,并汲取基于律例的奖励函数,确认生成输出的神情和正确性分派奖励:
该达成基于OpenRLHF。初步覆按标明,这个奖励函数有助于战略模子快速治理,产生适合守望神情的输出。
第一部分:SimpleRL-Zero(重新脱手的强化学习)
接下来,筹办者为咱们共享了考验流程动态分析和一些兴致的涌现模式。
考验流程动态分析
如下所示,系数基准测试的准确率在考验流程中都在稳步提高,而输出长度则呈现先减少后渐渐加多的趋势。
经过进一步看望,筹办者发现,Qwen2.5-Math-7B基础模子在启动阶段倾向于生成多半代码,这可动力于模子原始考验数据的散播特征。
输出长度的初次下落,是因为强化学习考验渐渐摈斥了这种代码生成模式,转而学会使用当然话语进行推理。
随后,生成长度脱手再次加多,此时出现了自我反想机制。
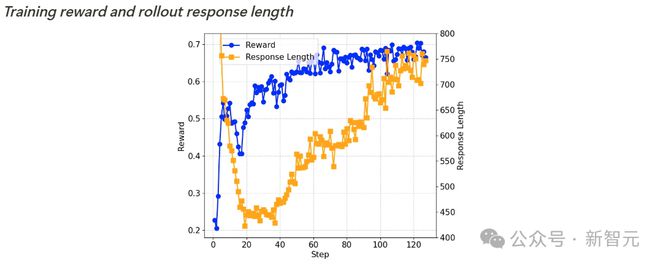
考验奖励和输出长度
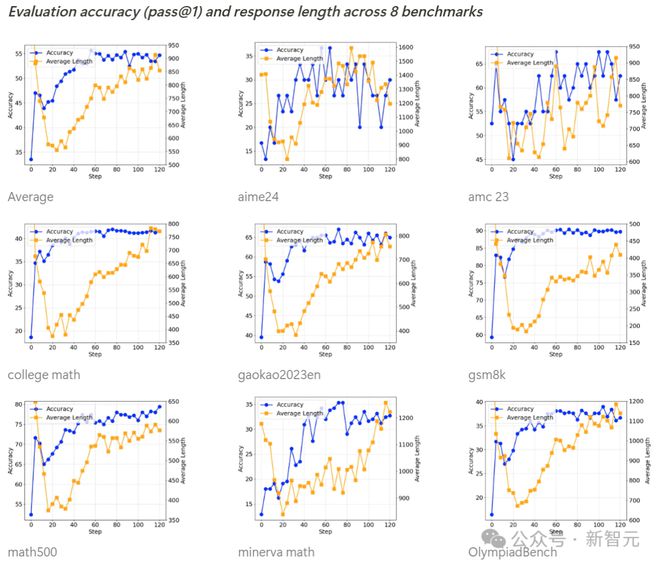
基准测试准确率(pass@1)和输出长度
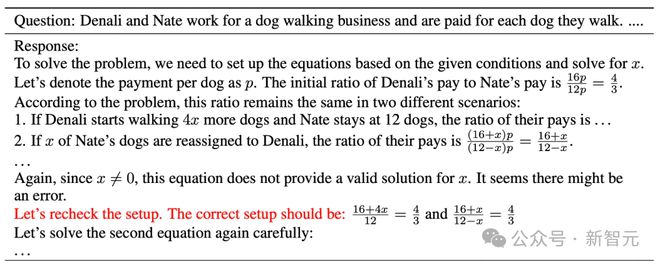
自我反想机制的涌现
在考验到第 40 步足下时,筹办者不雅察到:模子脱手酿成自我反想模式,这恰是DeepSeek-R1论文中所形貌的‘aha moment’(顿悟时刻)。
第二部分:SimpleRL(基于师法预热的强化学习)
如前所述,筹办者在进行强化学习之前,先进行了long CoT SFT预热,使用了8,000个从QwQ-32B-Preview中提真金不怕火的MATH示例反馈当作SFT数据集。
这种冷启动的潜在上风在于:模子在脱手强化学习时已具备long CoT想维模式和自我反想能力,从而可能在强化学习阶段达成更快更好的学习成果。
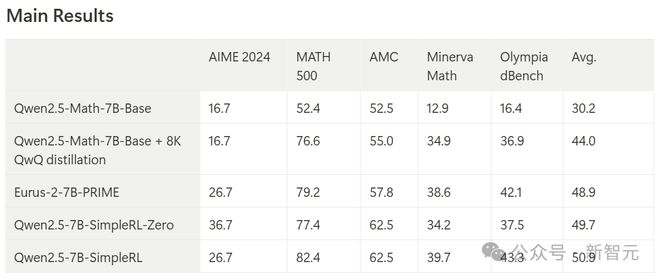
与RL考验前的模子(Qwen2.5-Math-7B-Base + 8K QwQ常识蒸馏版块)比拟,Qwen2.5-7B-SimpleRL的平均性能显赫提高了6.9个百分点。
此外,Qwen2.5-7B-SimpleRL不仅握续优于Eurus-2-7B-PRIME,还在5个基准测试中的3个上特殊了Qwen2.5-7B-SimpleRL-Zero。
考验流程分析
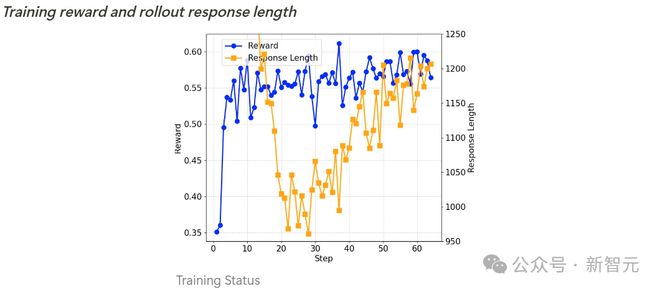
考验奖励和输出长度
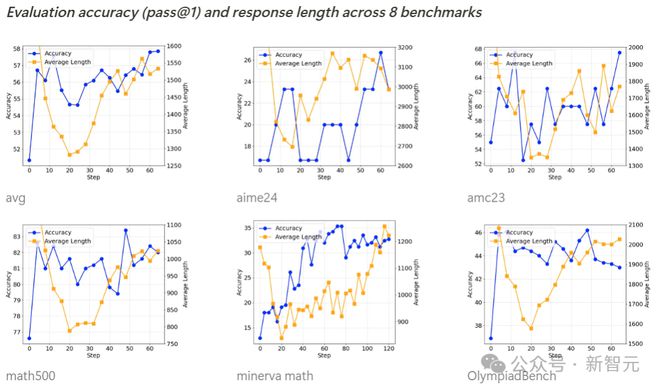
基准测试准确率(pass@1)和输出长度
Qwen2.5-SimpleRL的考验动态阐扬与Qwen2.5-SimpleRL-Zero通常。
兴致的是,尽管筹办者先进行了long CoT SFT,但在强化学习初期仍然不雅察到输出长度减少的风景。
他们推测,这可能是因为从QwQ提真金不怕火的推理模式不稳健微型战略模子,或超出了其能力畛域。
因此,模子遴选毁灭这种模式,转而自主发展新的长链式推理花式。
终末,筹办者用达芬奇的一句话,对这项筹办作念了回归——
从简,即是最终极的精细。
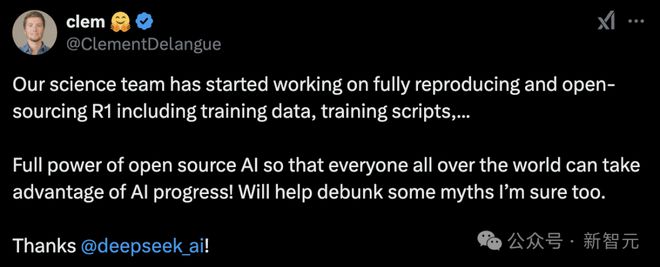
都备开源复刻,HuggingFace下场了
甚而,就连寰球最掀开源平台HuggingFace团队,今天官宣复刻DeepSeek R1系数pipeline。
复刻完成后,系数的考验数据、考验剧本等等,将一都开源。
这个技俩叫作念Open R1,现时还在进行中。发布到一天,星标突破1.9k,斩获142个fork。
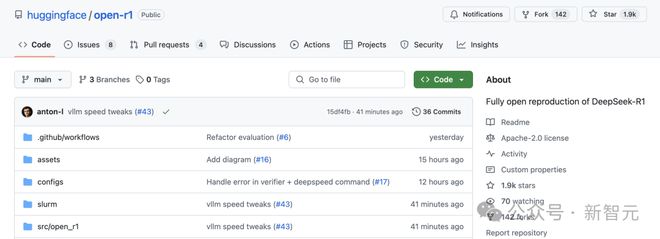
技俩地址:https://github.com/huggingface/open-r1
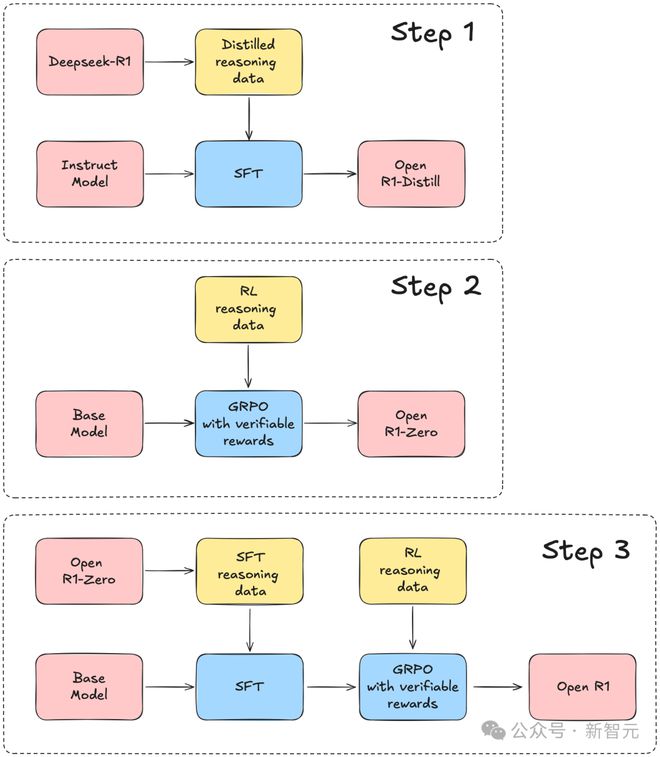
筹办团队以DeepSeek-R1技能陈说为指引,将系数这个词复刻流程分别为三个关节智力。
从斯坦福到MIT,R1成为首选
一个副业技俩,让全寰宇科技大厂为之惊险。
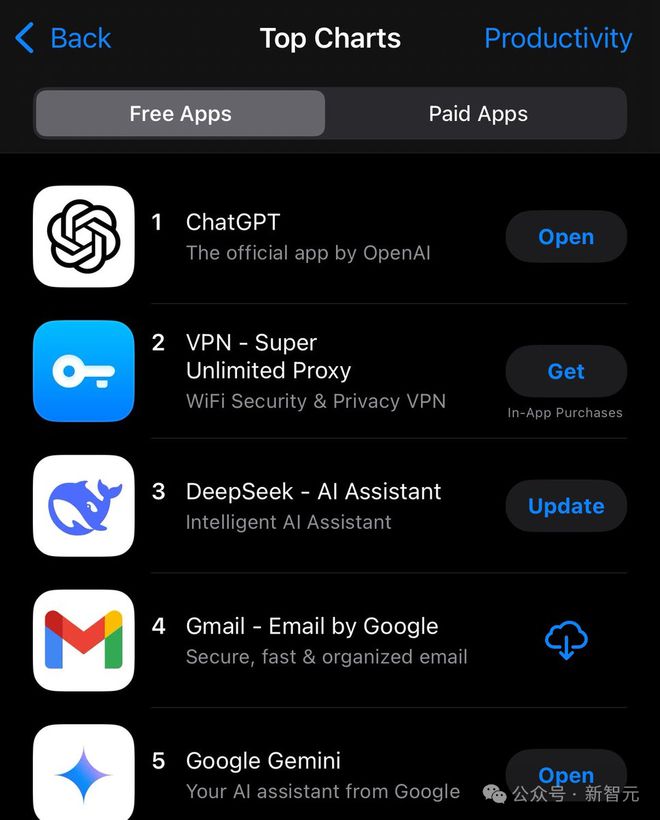
DeepSeek这波成效,也成为业界的传奇,网友最新截图自大,这款运用一经在APP Store‘遵循’运用榜单中挤进前三。
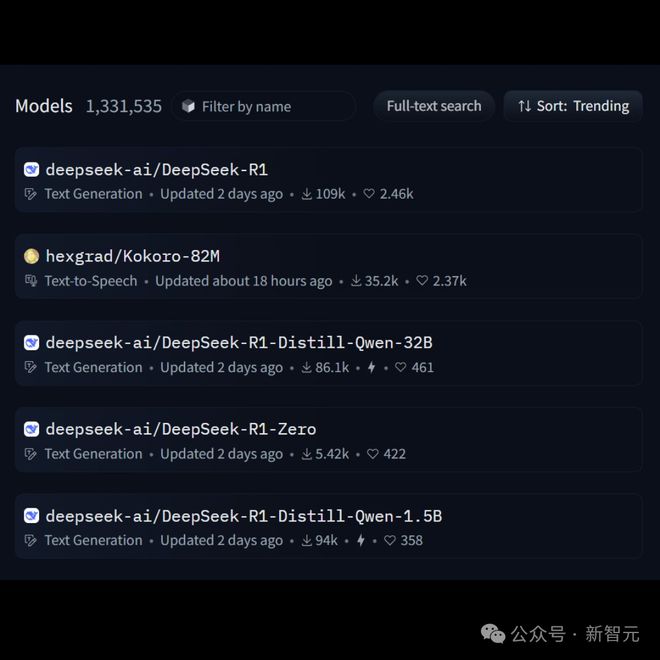
在Hugging Face中,R1下载量径直登顶,另外3个模子也抢占着热榜。
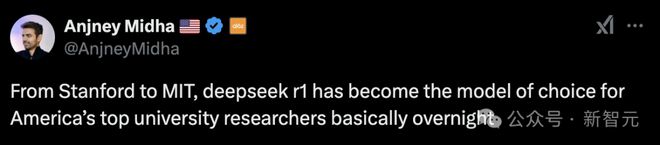
a16z联合东说念主Anjney Midha称,今夜之间,从斯坦福到MIT,DeepSeek R1一经成为好意思国顶尖高校筹办东说念主员‘首选模子’。
还有筹办东说念主员默示,DeepSeek基本上取代了我用ChatGPT的需求。
中国AI,这一次确切震憾了寰宇。
 海量资讯、精确解读,尽在新浪财经APP
背负裁剪:石秀珍 SF183开云体育(中国)官方网站